SQL débutant : le cours pas à pas et 12 exercices corrigés
L’essentiel en une minute
Ce cours SQL débutant part d’une petite boutique en ligne : trois tables, une vingtaine de lignes, et un script à copier pour la créer chez vous. Chaque notion est illustrée par une requête et par le résultat exact qu’elle renvoie, puis 12 exercices corrigés vous font pratiquer. Toutes les requêtes ont été exécutées sur SQLite avant publication.
Il traite aussi la sécurité, les valeurs NULL et les écarts entre SQLite, PostgreSQL et MySQL.
Points clés
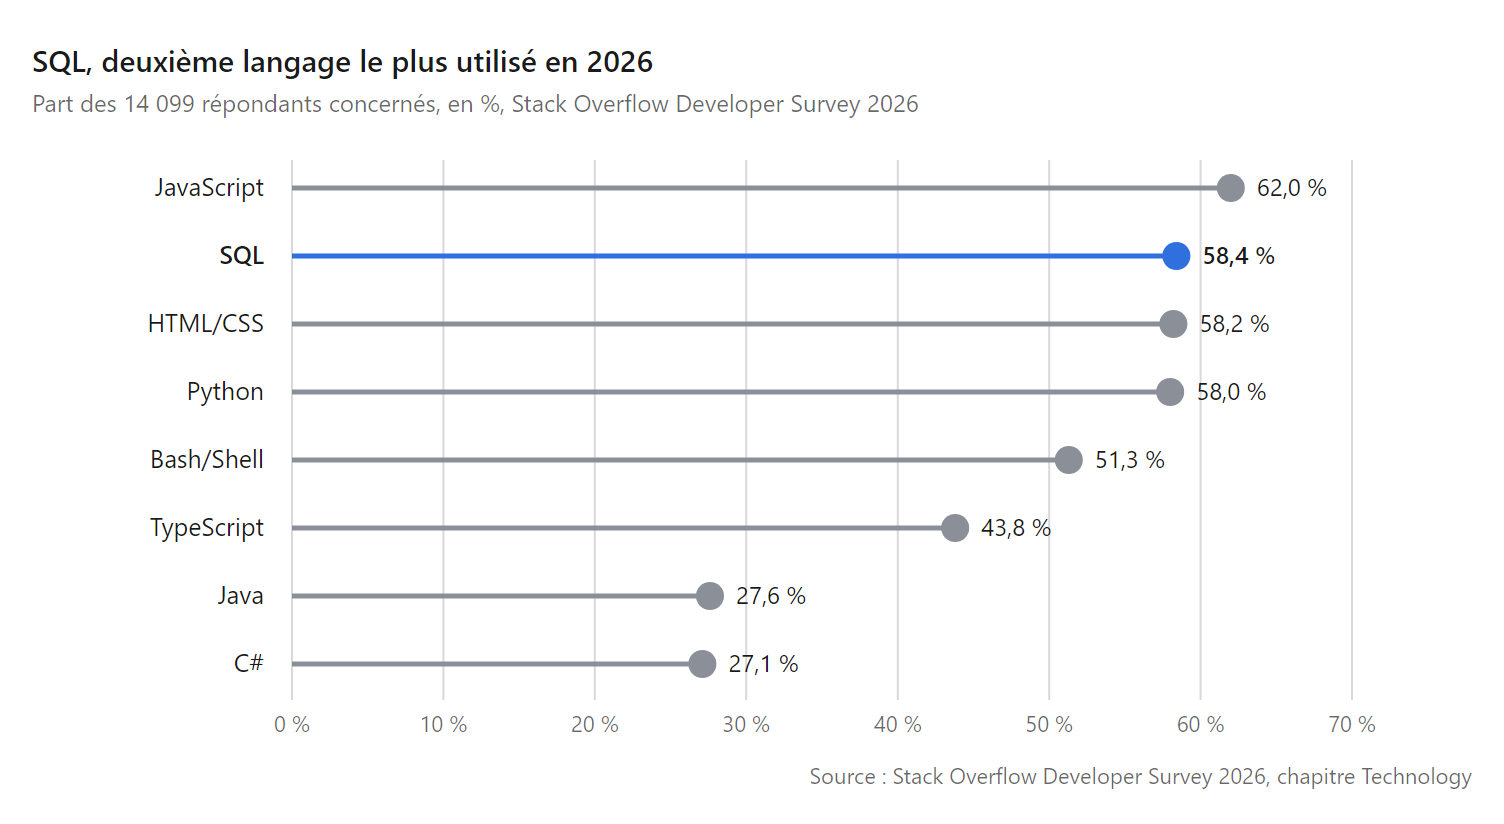
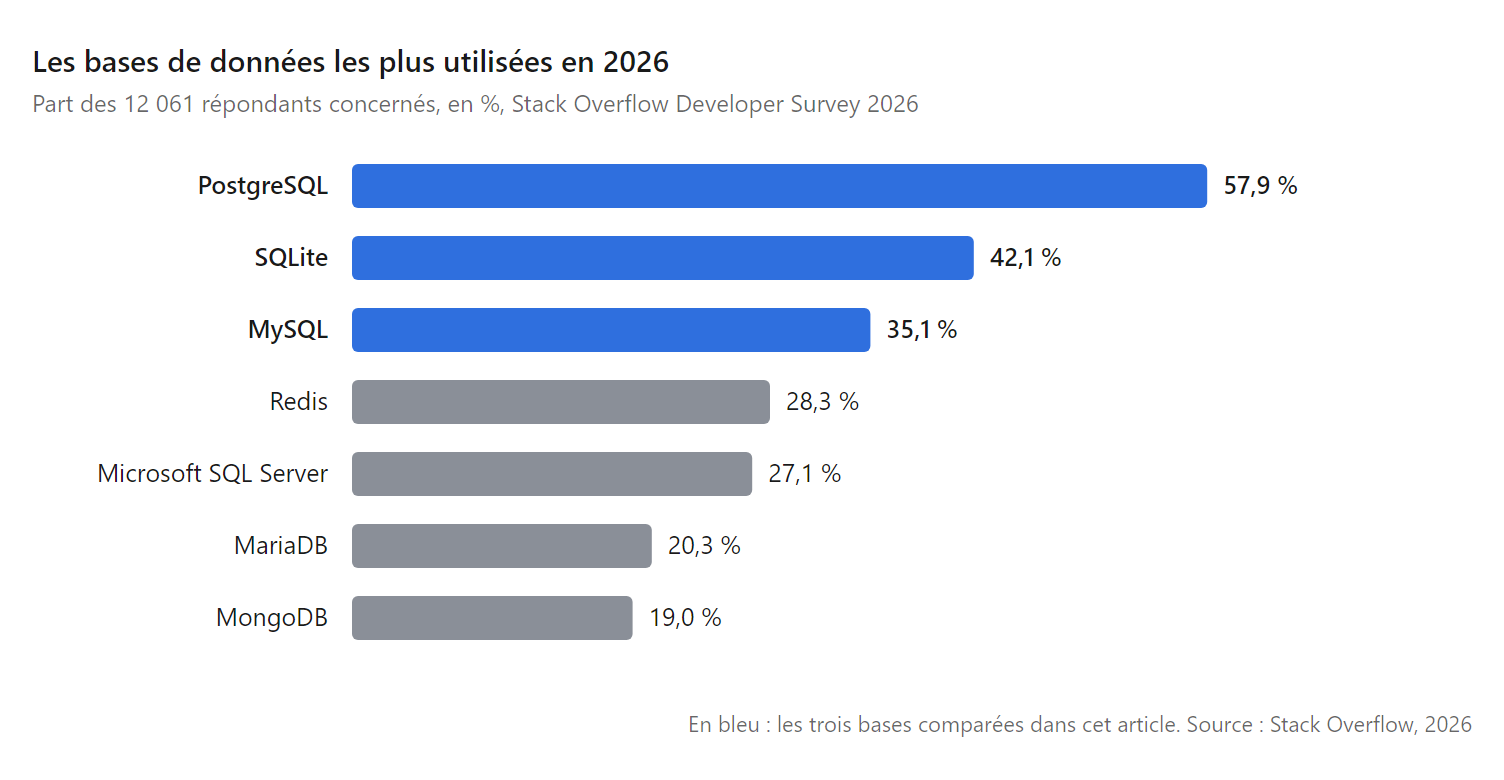
- SQL est le deuxième langage de l’enquête Stack Overflow 2026, à 58,4 %, et PostgreSQL, SQLite et MySQL y sont les trois bases les plus utilisées.
- Une requête de lecture s’écrit toujours dans cet ordre :
SELECT,FROM,WHERE,GROUP BY,HAVING,ORDER BY,LIMIT.INNER JOINne garde que les lignes qui ont une correspondance,LEFT JOINgarde toutes les lignes de la table de gauche.- Un
UPDATEou unDELETEsansWHEREtouche toute la table : travaillez dans une transaction.- Ne collez jamais une saisie utilisateur dans une requête : passez-la en paramètre.
Pourquoi apprendre SQL en 2026
SQL est le langage commun des bases de données relationnelles, et son usage reste stable. L’enquête annuelle de Stack Overflow a été menée du 23 juin au 5 août 2026 et retient 30 903 réponses valides (méthodologie de l’enquête 2026, consultée le 30 octobre 2026). SQL y est utilisé par 58,4 % des 14 099 répondants à la question sur les langages, au coude-à-coude avec HTML/CSS et Python, derrière JavaScript à 62,0 % (Stack Overflow Developer Survey 2026, consulté le 30 octobre 2026).
L’édition 2025 donnait 58,6 % pour SQL, sur un échantillon différent (Stack Overflow Developer Survey 2025, consulté le 30 octobre 2026) : un usage stable, pas une hausse.
SQL est déclaratif : vous décrivez le résultat voulu, et la base choisit comment l’obtenir. C’est ce qui le rend abordable pour un profil SQL débutant, même sans autre langage derrière.
Pour comparer les métiers, notre analyse des salaires des développeurs en France recoupe six études.
Préparer votre poste en cinq minutes
Le plus simple pour débuter est SQLite : la base tient dans un seul fichier, sans processus serveur, un choix assumé par sa documentation (SQLite, Quirks, consulté le 30 octobre 2026).
Deux options, au choix :
- L’outil en ligne de commande
sqlite3. Il se télécharge sur la page officielle de SQLite (paquet « sqlite-tools » pour Windows, macOS ou Linux). Lancezsqlite3 boutique.db, tapezPRAGMA foreign_keys = ON;pour activer les clés étrangères (à refaire à chaque ouverture), puis.read boutique.sqlpour charger le script, et.mode boxpour afficher des tableaux lisibles. Notre guide des commandes Linux de base aide à démarrer avec le terminal. - Python, déjà installé chez beaucoup. Le module
sqlite3fait partie de la bibliothèque standard. Le code ci-dessous crée la base à partir du script, clés étrangères activées.
import sqlite3

con = sqlite3.connect("boutique.db")
con.execute("PRAGMA foreign_keys = ON")
con.executescript(open("boutique.sql", encoding="utf-8").read())
Si vous découvrez Python, notre guide pour apprendre Python de zéro couvre l’installation.
La base d’exemple : clients, produits, commandes
La base contient trois tables : clients, produits et commandes, chaque commande reliant un client à un produit. Enregistrez ce script sous le nom boutique.sql. Il est écrit en SQL portable (les trois bases acceptent aussi DROP TABLE IF EXISTS, qui n’est pas dans la norme) et fonctionne tel quel sur SQLite ; les adaptations pour PostgreSQL et MySQL sont détaillées plus bas. Les trois DROP TABLE IF EXISTS du début effacent les tables existantes : relancer le script remet donc la base dans son état d’origine.
DROP TABLE IF EXISTS commandes;
DROP TABLE IF EXISTS produits;
DROP TABLE IF EXISTS clients;

CREATE TABLE clients (
  id               INTEGER PRIMARY KEY,
  nom              VARCHAR(100) NOT NULL,
  ville            VARCHAR(50),
  email            VARCHAR(255) UNIQUE,
  date_inscription DATE NOT NULL
);

CREATE TABLE produits (
  id        INTEGER PRIMARY KEY,
  nom       VARCHAR(100) NOT NULL,
  categorie VARCHAR(50) NOT NULL,
  prix      DECIMAL(10, 2) NOT NULL CHECK (prix >= 0)
);

CREATE TABLE commandes (
  id            INTEGER PRIMARY KEY,
  client_id     INTEGER NOT NULL,
  produit_id    INTEGER NOT NULL,
  quantite      INTEGER NOT NULL CHECK (quantite > 0),
  date_commande DATE NOT NULL,
  FOREIGN KEY (client_id)  REFERENCES clients (id),
  FOREIGN KEY (produit_id) REFERENCES produits (id)
);

INSERT INTO clients (id, nom, ville, email, date_inscription) VALUES
  (1, 'Alice Martin',  'Paris',     '[email protected]',  '2026-01-15'),
  (2, 'Karim Benali',  'Lyon',      '[email protected]',  '2026-02-03'),
  (3, 'Sophie Durand', 'Paris',     '[email protected]', '2026-03-20'),
  (4, 'Lucas Petit',   'Marseille', NULL,                '2026-04-11'),
  (5, 'Emma Leroy',    NULL,        '[email protected]',   '2026-05-02'),
  (6, 'Yanis Moreau',  'Lyon',      '[email protected]',  '2026-06-18');

INSERT INTO produits (id, nom, categorie, prix) VALUES
  (1, 'Clavier mécanique',  'Informatique', 89.00),
  (2, 'Souris sans fil',    'Informatique', 25.50),
  (3, 'Écran 27 pouces',    'Informatique', 249.00),
  (4, 'Cahier A5',          'Papeterie',    4.50),
  (5, 'Stylos gel (x10)',   'Papeterie',    12.75),
  (6, 'Lampe de bureau',    'Mobilier',     39.00),
  (7, 'Chaise ergonomique', 'Mobilier',     199.00);

INSERT INTO commandes (id, client_id, produit_id, quantite, date_commande) VALUES
  (1,  1, 1, 1,  '2026-07-02'),
  (2,  1, 2, 2,  '2026-07-02'),
  (3,  2, 3, 1,  '2026-07-15'),
  (4,  3, 4, 10, '2026-08-01'),
  (5,  3, 5, 2,  '2026-08-01'),
  (6,  2, 2, 1,  '2026-08-20'),
  (7,  4, 6, 1,  '2026-09-05'),
  (8,  1, 4, 5,  '2026-09-12'),
  (9,  5, 1, 1,  '2026-09-30'),
  (10, 3, 3, 1,  '2026-10-03');
Deux pièges sont posés exprès : Lucas n’a pas d’e-mail et Emma pas de ville. Ils serviront dans la partie sur NULL. Yanis n’a rien commandé et la chaise n’a jamais été vendue : les jointures les feront apparaître.
Lire des données : SELECT, WHERE, ORDER BY, LIMIT
Une requête de lecture dit quelles colonnes afficher (SELECT), depuis quelle table (FROM), pour quelles lignes (WHERE), dans quel ordre (ORDER BY) et combien (LIMIT). L’astérisque sélectionne toutes les colonnes ; en pratique, nommez celles dont vous avez besoin.
SELECT nom, email FROM clients WHERE ville = 'Paris' ORDER BY nom;
| nom | |
|---|---|
| Alice Martin | [email protected] |
| Sophie Durand | [email protected] |
Les chaînes s’écrivent entre apostrophes simples. Les guillemets doubles servent aux noms de colonnes dans la norme ; SQLite les accepte pour des chaînes, mais sa documentation le classe parmi ses bizarreries, car une faute de frappe dans un nom de colonne devient alors une chaîne au lieu d’une erreur (SQLite, Quirks).
WHERE combine les conditions avec AND, OR et NOT, et dispose de raccourcis utiles :
| Opérateur | Exemple | Ce qu’il garde |
|---|---|---|
=, <>, <, >= |
prix < 100 |
Comparaison simple |
IN |
ville IN ('Lyon', 'Marseille') |
Une valeur parmi une liste |
BETWEEN |
date_commande BETWEEN '2026-08-01' AND '2026-08-31' |
Un intervalle, bornes comprises |
LIKE |
nom LIKE 'S%' |
Un motif : % pour n’importe quelle suite, _ pour un caractère |
IS NULL |
email IS NULL |
Une valeur absente |
Pour trier et limiter, ajoutez ORDER BY puis LIMIT. Voici les trois produits les plus chers :
SELECT nom, prix FROM produits
ORDER BY prix DESC
LIMIT 3;
| nom | prix |
|---|---|
| Écran 27 pouces | 249 |
| Chaise ergonomique | 199 |
| Clavier mécanique | 89 |
SQLite affiche 249 et non 249.00 : il ne stocke pas de type décimal fixe, nous y revenons plus bas. Sans ORDER BY, l’ordre des lignes n’est pas garanti. La documentation de PostgreSQL insiste : avec LIMIT, un tri qui donne un ordre unique est nécessaire, sinon vous obtenez un sous-ensemble imprévisible des lignes (PostgreSQL 18, LIMIT et OFFSET, consulté le 30 octobre 2026).
Enfin, SELECT DISTINCT ville FROM clients renvoie chaque ville une seule fois. Sur notre base, il renvoie quatre lignes : Lyon, Marseille, Paris, plus une ligne NULL pour Emma, car DISTINCT traite NULL comme une valeur à part entière.
Compter et regrouper : GROUP BY et HAVING
Les fonctions d’agrégat résument plusieurs lignes en une valeur : COUNT, SUM, AVG, MIN et MAX. Sans GROUP BY, elles portent sur toute la table.
SELECT COUNT(*) AS nb_produits,
       MIN(prix)  AS moins_cher,
       MAX(prix)  AS plus_cher,
       ROUND(AVG(prix), 2) AS prix_moyen
FROM produits;
| nb_produits | moins_cher | plus_cher | prix_moyen |
|---|---|---|---|
| 7 | 4.5 | 249 | 88.39 |
GROUP BY calcule un agrégat par groupe. Ici, le nombre de produits et le prix moyen par catégorie :
SELECT categorie, COUNT(*) AS nb, ROUND(AVG(prix), 2) AS prix_moyen
FROM produits
GROUP BY categorie
ORDER BY nb DESC, categorie;
| categorie | nb | prix_moyen |
|---|---|---|
| Informatique | 3 | 121.17 |
| Mobilier | 2 | 119.0 |
| Papeterie | 2 | 8.63 |
La règle à retenir : toute colonne du SELECT qui n’est pas dans un agrégat doit figurer dans le GROUP BY. SQLite tolère qu’on l’oublie et prend alors une valeur d’une des lignes du groupe (SQLite, Quirks). PostgreSQL refuse ce genre de requête (PostgreSQL 18, SELECT), tout comme MySQL 8.4, dont le mode SQL par défaut inclut ONLY_FULL_GROUP_BY (MySQL 8.4, modes SQL). Prenez la bonne habitude dès le départ.
WHERE filtre les lignes avant le regroupement, HAVING filtre les groupes après. Les clients qui ont passé au moins trois commandes :
SELECT client_id, COUNT(*) AS nb_commandes
FROM commandes
GROUP BY client_id
HAVING COUNT(*) >= 3
ORDER BY client_id;
| client_id | nb_commandes |
|---|---|
| 1 | 3 |
| 3 | 3 |
Croiser les tables : INNER JOIN et LEFT JOIN
Une jointure assemble les lignes de deux tables qui partagent une valeur, ici l’identifiant du client ou du produit. Sans elle, la table commandes ne montre que des numéros.
SELECT c.nom AS client, p.nom AS produit, co.quantite,
       co.quantite * p.prix AS montant
FROM commandes AS co
INNER JOIN clients  AS c ON c.id = co.client_id
INNER JOIN produits AS p ON p.id = co.produit_id
WHERE co.date_commande >= '2026-09-01'
ORDER BY co.date_commande;
| client | produit | quantite | montant |
|---|---|---|---|
| Lucas Petit | Lampe de bureau | 1 | 39 |
| Alice Martin | Cahier A5 | 5 | 22.5 |
| Emma Leroy | Clavier mécanique | 1 | 89 |
| Sophie Durand | Écran 27 pouces | 1 | 249 |
Les alias (co, c, p) lèvent l’ambiguïté entre les colonnes nom et id des trois tables. Les dates au format ISO AAAA-MM-JJ se comparent comme des chaînes.
INNER JOIN écarte les lignes sans correspondance : Yanis, qui n’a rien commandé, n’apparaît jamais. LEFT JOIN garde toutes les lignes de la table de gauche et remplit les colonnes manquantes avec NULL :
SELECT c.nom, COUNT(co.id) AS nb_commandes
FROM clients AS c
LEFT JOIN commandes AS co ON co.client_id = c.id
GROUP BY c.id, c.nom
ORDER BY nb_commandes DESC, c.nom;
| nom | nb_commandes |
|---|---|
| Alice Martin | 3 |
| Sophie Durand | 3 |
| Karim Benali | 2 |
| Emma Leroy | 1 |
| Lucas Petit | 1 |
| Yanis Moreau | 0 |
Notez COUNT(co.id) : COUNT(*) compterait 1 pour Yanis, dont la ligne existe même sans commande. Pour ne garder que les clients sans commande, ajoutez WHERE co.id IS NULL : la requête renvoie alors Yanis Moreau seul.
RIGHT JOIN est le miroir de LEFT JOIN. La documentation de MySQL recommande LEFT JOIN pour que le code reste portable (MySQL 8.4, JOIN, consulté le 30 octobre 2026).
Modifier les données sans rien casser
INSERT ajoute des lignes, UPDATE les modifie et DELETE les supprime. Les deux derniers agissent sur toutes les lignes que sélectionne leur WHERE, et sur toute la table s’il n’y en a pas.
INSERT INTO clients (nom, ville, email, date_inscription)
VALUES ('Inès Garcia', 'Toulouse', '[email protected]', '2026-10-30');

UPDATE clients SET ville = 'Bordeaux' WHERE id = 7;

DELETE FROM clients WHERE id = 7;
Sans id fourni, SQLite a attribué le numéro 7 à la nouvelle cliente ; l’UPDATE puis le DELETE ont chacun touché une ligne.
Attention. Avant tout
UPDATEouDELETE, lancez unSELECTavec le mêmeWHEREet vérifiez le nombre de lignes. Travaillez dans une transaction : si le résultat vous surprend,ROLLBACKannule tout. Faites une copie de la base avant une opération en production.
BEGIN;
UPDATE produits SET prix = 0;   -- oubli du WHERE : 7 lignes modifiées
ROLLBACK;                       -- les prix d'origine sont rétablis
Nous avons exécuté ce scénario : l’UPDATE a modifié les 7 produits, et le ROLLBACK a rendu les prix d’origine. COMMIT valide la transaction quand le résultat est correct.
Clés primaires, clés étrangères et index
La clé primaire identifie chaque ligne de façon unique : ici la colonne id. La clé étrangère garantit qu’une valeur pointe vers une ligne existante : commandes.client_id doit correspondre à un clients.id.
Sur notre base, avec les clés étrangères actives, deux opérations échouent avec l’erreur FOREIGN KEY constraint failed : supprimer Alice, qui a des commandes, et créer une commande pour un client 99 qui n’existe pas. De même, insérer un second client avec l’adresse d’Alice échoue sur la contrainte UNIQUE.
Le piège propre à SQLite : les clés étrangères sont désactivées par défaut, pour des raisons de compatibilité, et doivent être activées à chaque connexion avec PRAGMA foreign_keys = ON (SQLite, Foreign Key Support, consulté le 30 octobre 2026). Sans cette ligne, notre commande pour le client 99 a été acceptée sans erreur. Le module node:sqlite de Node.js fait l’inverse : son option enableForeignKeyConstraints vaut true par défaut (documentation de Node.js, consultée le 30 octobre 2026), ce dont profite notre tutoriel d’API REST avec Node.js.
PostgreSQL applique les clés étrangères d’office (PostgreSQL 18, contraintes). MySQL aussi avec InnoDB, son moteur par défaut, puisque la variable foreign_key_checks y est activée par défaut, à une condition : selon la documentation de MySQL 8.4, il analyse puis ignore les REFERENCES écrits dans la définition d’une colonne, et n’accepte que des clauses FOREIGN KEY (...) REFERENCES ... séparées (MySQL 8.4, CREATE TABLE et clés étrangères). Notre script utilise donc cette forme, valable sur les trois bases.
Un index accélère la recherche sur une colonne, comme l’index d’un livre. La commande EXPLAIN QUERY PLAN de SQLite montre la différence :
EXPLAIN QUERY PLAN SELECT * FROM commandes WHERE client_id = 3;
-- SCAN commandes          (lecture de toute la table)

CREATE INDEX idx_commandes_client ON commandes (client_id);

EXPLAIN QUERY PLAN SELECT * FROM commandes WHERE client_id = 3;
-- SEARCH commandes USING INDEX idx_commandes_client (client_id=?)
Un index a un coût : selon la documentation de PostgreSQL, la base doit le tenir à jour, ce qui alourdit les écritures (PostgreSQL 18, index, consulté le 30 octobre 2026). Indexez les colonnes souvent filtrées ou jointes, pas toutes.
Les pièges de NULL
NULL ne signifie pas zéro ni chaîne vide, mais « valeur inconnue ». Toute comparaison avec NULL donne NULL, donc ni vrai ni faux. La documentation de MySQL le dit en une phrase : on ne peut pas tester NULL avec =, < ou <> (MySQL 8.4, Working with NULL Values, consulté le 30 octobre 2026).
Cinq pièges, tous vérifiés sur notre base :
| Requête | Résultat obtenu | Explication |
|---|---|---|
WHERE ville = NULL |
0 ligne | La comparaison donne NULL ; il faut IS NULL |
WHERE ville IS NULL |
Emma Leroy | La bonne écriture |
WHERE ville <> 'Paris' |
3 lignes, sans Emma | Une ville inconnue n’est pas « différente de Paris » |
COUNT(*), COUNT(email) |
6 et 5 | COUNT(colonne) ignore les NULL |
WHERE id NOT IN (SELECT NULL UNION SELECT 1) |
0 ligne | Un seul NULL dans la liste vide un NOT IN |
Pour remplacer une valeur absente à l’affichage, utilisez COALESCE(ville, 'inconnue'), qui renvoie le premier argument non NULL. Pour inclure Emma dans la recherche, écrivez WHERE ville IS NULL OR ville <> 'Paris'.
Le tri des NULL varie selon la base. SQLite les considère plus petits que toute autre valeur, donc en tête d’un tri croissant (SQLite, SELECT) ; MySQL aussi (MySQL 8.4, Working with NULL Values). PostgreSQL les traite comme plus grands, donc en fin de tri croissant (PostgreSQL 18, tri). NULLS FIRST ou NULLS LAST fixent le comportement là où ils existent.
L’injection SQL et les requêtes paramétrées
L’injection SQL survient quand une saisie utilisateur est collée dans le texte d’une requête : l’attaquant écrit du SQL au lieu d’une valeur.
Ce programme Python a été exécuté sur notre base :
import sqlite3

con = sqlite3.connect("boutique.db")
saisie = "x' OR '1'='1"   # ce qu'un attaquant tape dans le formulaire

# À NE JAMAIS FAIRE : la saisie devient du code SQL
requete = "SELECT nom, email FROM clients WHERE email = '" + saisie + "'"
print(len(con.execute(requete).fetchall()))   # 6 : toute la table

# La bonne méthode : un paramètre lié par le pilote
lignes = con.execute(
    "SELECT nom, email FROM clients WHERE email = ?", (saisie,)
).fetchall()
print(len(lignes))                             # 0
La première version produit WHERE email = 'x' OR '1'='1', une condition toujours vraie : les six clients et leurs e-mails fuient. La seconde envoie la saisie comme une simple valeur, qui ne correspond à aucun e-mail.
L’OWASP place les requêtes préparées avec paramètres en tête des défenses, et classe l’échappement manuel des saisies comme « fortement déconseillé » (notre traduction) (OWASP, SQL Injection Prevention Cheat Sheet, consulté le 30 octobre 2026). La documentation de Python demande elle aussi d’utiliser toujours les marqueurs plutôt que des chaînes formatées (module sqlite3).
Le principe vaut dans tous les langages. Notre tutoriel pour créer une API REST avec Node.js l’applique à une base SQLite : toutes ses requêtes passent par db.prepare() avec des paramètres ?.
SQLite, PostgreSQL et MySQL : ce qui change
Les trois bases parlent SQL, mais pas exactement le même. PostgreSQL arrive en tête de l’enquête Stack Overflow 2026 avec 57,9 % des 12 061 répondants à la question sur les bases, devant SQLite à 42,1 % et MySQL à 35,1 % (Stack Overflow Developer Survey 2026).
Les écarts qui comptent pour un débutant, relevés dans la documentation officielle de chaque base :
| Point | SQLite | PostgreSQL | MySQL 8.4 |
|---|---|---|---|
| Identifiant automatique | INTEGER PRIMARY KEY |
GENERATED ALWAYS AS IDENTITY |
AUTO_INCREMENT |
| Clés étrangères | Désactivées par défaut | Actives | Actives avec InnoDB |
| Types | Souples, sauf tables STRICT |
Stricts | Stricts avec le mode par défaut |
| NULL dans un tri croissant | En tête | En fin | En tête |
FULL OUTER JOIN |
Depuis la version 3.39.0 | Oui | Absent de la syntaxe |
\|\| |
Concatène | Concatène | « OU » logique par défaut (obsolète) |
Les sources de ce tableau : les pages Quirks, AUTOINCREMENT et notes de version 3.39.0 de SQLite ; les pages colonnes d’identité, contraintes, conversion de types et SELECT de PostgreSQL ; les pages AUTO_INCREMENT, modes SQL et opérateurs logiques de MySQL, toutes consultées le 30 octobre 2026. La page de conversion de types de PostgreSQL rappelle que SQL est un langage fortement typé ; le mode SQL par défaut de MySQL 8.4 inclut STRICT_TRANS_TABLES.
Pour rejouer notre script sur PostgreSQL ou MySQL, le point délicat est l’identifiant. Comme les id y sont écrits à la main, c’est surtout l’INSERT sans id du chapitre suivant qui demande une adaptation.
Sur PostgreSQL, une colonne GENERATED ALWAYS AS IDENTITY refuse les id écrits à la main, sauf avec OVERRIDING SYSTEM VALUE. Avec GENERATED BY DEFAULT, la valeur fournie l’emporte, mais elle ne passe pas par la séquence, et la documentation prévient qu’une colonne d’identité ne garantit alors plus l’unicité. Le plus simple : déclarez les id en identité et retirez-les des trois INSERT (clients, produits et commandes) ; sur une table neuve, les lignes reçoivent en pratique les mêmes numéros. Sur MySQL, ajoutez AUTO_INCREMENT aux id : il accepte les valeurs écrites à la main et reprend ensuite la numérotation après la plus grande.
La souplesse de SQLite surprend : il a accepté le texte 'gratuit' dans la colonne prix, déclarée DECIMAL, ce que sa documentation assume. Elle note aussi que upper() et lower() ne traitent que les caractères ASCII : sur notre base, lower('Écran') renvoie Écran, la majuscule accentuée reste.
Enfin, LIMIT n’est pas standard : la norme SQL:2008 prévoit FETCH FIRST n ROWS ONLY, selon la page SELECT de PostgreSQL. Pour lancer PostgreSQL sans l’installer, notre tutoriel Docker pour débutants le démarre dans Docker Compose.
12 exercices SQL débutant corrigés
Ces 12 exercices SQL débutant portent sur la base d’exemple. Relancez le script boutique.sql avant de commencer, pour repartir des données d’origine, cherchez chaque requête sans regarder, puis comparez votre résultat au tableau. Toutes les solutions ont été exécutées dans l’ordre, sur la base d’origine.
Exercice 1 : les produits de papeterie
Affichez le nom et le prix des produits de la catégorie Papeterie.
SELECT nom, prix FROM produits WHERE categorie = 'Papeterie'
ORDER BY prix;
| nom | prix |
|---|---|
| Cahier A5 | 4.5 |
| Stylos gel (x10) | 12.75 |
Exercice 2 : les deux derniers inscrits
Affichez le nom et la date d’inscription des deux clients inscrits le plus récemment.
SELECT nom, date_inscription FROM clients
ORDER BY date_inscription DESC
LIMIT 2;
| nom | date_inscription |
|---|---|
| Yanis Moreau | 2026-06-18 |
| Emma Leroy | 2026-05-02 |
Exercice 3 : une fourchette de prix
Listez les produits entre 20 et 100 euros, du moins cher au plus cher.
SELECT nom, prix FROM produits
WHERE prix BETWEEN 20 AND 100
ORDER BY prix;
| nom | prix |
|---|---|
| Souris sans fil | 25.5 |
| Lampe de bureau | 39 |
| Clavier mécanique | 89 |
Exercice 4 : les clients sans e-mail
Trouvez les clients dont l’e-mail n’est pas renseigné.
SELECT nom FROM clients WHERE email IS NULL;
| nom |
|---|
| Lucas Petit |
Écrire email = NULL aurait renvoyé zéro ligne.
Exercice 5 : le bilan de juillet
Comptez les commandes passées en juillet 2026 et le nombre d’articles commandés.
SELECT COUNT(*) AS nb, SUM(quantite) AS articles
FROM commandes
WHERE date_commande BETWEEN '2026-07-01' AND '2026-07-31';
| nb | articles |
|---|---|
| 3 | 4 |
Exercice 6 : les clients par ville
Comptez les clients par ville, en ignorant les villes inconnues, du plus grand nombre au plus petit.
SELECT ville, COUNT(*) AS nb_clients
FROM clients
WHERE ville IS NOT NULL
GROUP BY ville
ORDER BY nb_clients DESC, ville;
| ville | nb_clients |
|---|---|
| Lyon | 2 |
| Paris | 2 |
| Marseille | 1 |
Exercice 7 : le total dépensé par client
Calculez le montant total dépensé par chaque client, du plus gros au plus petit.
SELECT c.nom, SUM(co.quantite * p.prix) AS total
FROM commandes AS co
JOIN clients  AS c ON c.id = co.client_id
JOIN produits AS p ON p.id = co.produit_id
GROUP BY c.id, c.nom
ORDER BY total DESC;
| nom | total |
|---|---|
| Sophie Durand | 319.5 |
| Karim Benali | 274.5 |
| Alice Martin | 162.5 |
| Emma Leroy | 89 |
| Lucas Petit | 39 |
JOIN seul équivaut à INNER JOIN. Yanis n’apparaît pas, puisqu’il n’a rien commandé.
Exercice 8 : le produit jamais vendu
Trouvez les produits qui n’apparaissent dans aucune commande.
SELECT p.nom
FROM produits AS p
LEFT JOIN commandes AS co ON co.produit_id = p.id
WHERE co.id IS NULL;
| nom |
|---|
| Chaise ergonomique |
Exercice 9 : le chiffre d’affaires par catégorie
Calculez le chiffre d’affaires de chaque catégorie et ne gardez que celles qui dépassent 50 euros.
SELECT p.categorie, SUM(co.quantite * p.prix) AS chiffre_affaires
FROM commandes AS co
JOIN produits AS p ON p.id = co.produit_id
GROUP BY p.categorie
HAVING SUM(co.quantite * p.prix) > 50
ORDER BY chiffre_affaires DESC;
| categorie | chiffre_affaires |
|---|---|
| Informatique | 752.5 |
| Papeterie | 93.0 |
Le mobilier, à 39 euros, est filtré par HAVING. Un WHERE ne pourrait pas le faire, car le total n’existe qu’après le regroupement.
Exercice 10 : la dernière commande de chaque client
Affichez chaque client avec la date de sa dernière commande, y compris ceux qui n’ont jamais commandé.
SELECT c.nom, MAX(co.date_commande) AS derniere_commande
FROM clients AS c
LEFT JOIN commandes AS co ON co.client_id = c.id
GROUP BY c.id, c.nom
ORDER BY c.id;
| nom | derniere_commande |
|---|---|
| Alice Martin | 2026-09-12 |
| Karim Benali | 2026-08-20 |
| Sophie Durand | 2026-10-03 |
| Lucas Petit | 2026-09-05 |
| Emma Leroy | 2026-09-30 |
| Yanis Moreau | NULL |
Exercice 11 : plus cher que la moyenne
Listez les produits dont le prix dépasse le prix moyen de la table, sans écrire ce prix moyen à la main.
SELECT nom, prix FROM produits
WHERE prix > (SELECT AVG(prix) FROM produits)
ORDER BY prix DESC;
| nom | prix |
|---|---|
| Écran 27 pouces | 249 |
| Chaise ergonomique | 199 |
| Clavier mécanique | 89 |
La sous-requête calcule la moyenne, 88,39 euros, puis la requête principale compare chaque prix.
Exercice 12 : une hausse de prix en sécurité
Augmentez de 10 % les prix du mobilier, vérifiez le résultat, puis annulez.
BEGIN;
UPDATE produits
SET prix = ROUND(prix * 1.10, 2)
WHERE categorie = 'Mobilier';
SELECT nom, prix FROM produits WHERE categorie = 'Mobilier';
ROLLBACK;
| nom | prix |
|---|---|
| Lampe de bureau | 42.9 |
| Chaise ergonomique | 218.9 |
L’UPDATE a touché deux lignes. Remplacez ROLLBACK par COMMIT pour garder la hausse.
Pour continuer, passez à nos 19 exercices Python débutant corrigés, puis reliez Python et SQL avec le module sqlite3.
Ce que nous n’avons pas pu vérifier
Les points suivants restent ouverts :
- Les résultats sur PostgreSQL et MySQL. Les requêtes ont été exécutées sur SQLite 3.45.1 seulement. Les écarts avec PostgreSQL et MySQL viennent de leur documentation, pas d’une exécution. L’affichage des nombres y sera différent (
249.00au lieu de249). - La dernière version de SQLite. La page de téléchargement proposait la version 3.54.1 le 30 octobre 2026. Nos requêtes n’utilisent aucune fonction récente, mais nous ne les avons pas rejouées sur cette version.
- La portée de l’enquête Stack Overflow. Ses répondants sont des volontaires venus de la communauté du site, pas un échantillon représentatif de tous les développeurs.
Questions fréquentes
Combien de temps faut-il pour apprendre SQL quand on est débutant ?
Selon notre estimation, pas une mesure, les notions de ce cours s’apprennent en quelques séances si vous pratiquez chaque requête. La maîtrise vient ensuite avec de vraies bases, plus grandes que notre exemple.
Quelle base choisir pour un cours SQL débutant ?
SQLite pour démarrer, car il n’y a rien à configurer et toute la base tient dans un fichier. Passez ensuite à PostgreSQL, la base la plus utilisée de l’enquête Stack Overflow 2026, pour vous habituer à des types stricts et à un serveur.
Existe-t-il une formation SQL débutant gratuite ?
Oui. Ce cours et ses 12 exercices sont gratuits, tout comme les documentations officielles de SQLite et de PostgreSQL, dont le tutoriel couvre les mêmes bases. La Wild Code School propose aussi un cours SQL en libre accès d’environ 5 h 30, avec quiz.
Faut-il connaître un langage de programmation avant SQL ?
Non. SQL se pratique seul, dans l’outil sqlite3. Un langage comme Python devient utile pour intégrer les requêtes dans une application, et c’est là que les requêtes paramétrées s’imposent.
À propos de l’auteur
Abdelilah Ourti est ingénieur IA et architecte logiciel. Il conçoit et déploie des applications web et des systèmes d’IA, et publie sur NeurauTech des guides et des comparatifs destinés aux développeurs francophones. Ses autres articles sont réunis sur sa page auteur.
Méthode. Le cours et les exercices ont été écrits pour cet article. Le script de la base, chaque requête du cours et chaque solution ont été exécutés sur SQLite 3.45.1, via le module sqlite3 de Python 3.11.9, et les résultats recopiés tels quels. Les différences avec PostgreSQL et MySQL viennent de leur documentation officielle (PostgreSQL 18, MySQL 8.4) ; les recommandations de sécurité, de l’OWASP ; les chiffres d’usage, de l’enquête Stack Overflow 2026. Aucun lien n’est affilié et aucune relation commerciale ne lie l’auteur aux éditeurs mentionnés.
Une erreur dans une solution ? Écrivez à [email protected] : l’article sera corrigé et la date de mise à jour modifiée.
Dernière mise à jour : 30 octobre 2026.
Image : Sunder Muthukumaran (Unsplash License). Graphiques : NeurauTech, d’après le Stack Overflow Developer Survey 2026.