PostgreSQL vs MySQL en 2026 : versions, syntaxe, index et grille de choix
La réponse courte
Le match PostgreSQL vs MySQL ne se gagne pas sur la vitesse brute : les deux moteurs sont relationnels, transactionnels et libres. Ils se séparent sur la richesse fonctionnelle, la licence, les transactions par défaut et l’écosystème : PostgreSQL offre plus de types, d’index et d’extensions ; MySQL et MariaDB restent les bases exigées par WordPress.
Cet article synthétise des sources publiques lues le 5 novembre 2026, sans test ni benchmark de notre part.
Points clés
- Versions stables au 5 novembre 2026 : PostgreSQL 18.6 (la 19 est en release candidate depuis le 15 octobre) et MySQL 9.7 LTS, avec MySQL 26.10 en version Innovation depuis le 20 octobre.
- PostgreSQL est sous une licence permissive de type BSD ou MIT ; MySQL est sous GPLv2 ou sous licence commerciale d’Oracle.
- Par défaut, PostgreSQL travaille en Read Committed et InnoDB en Repeatable Read : le même code peut donc voir des données différentes.
- Pour l’IA, pgvector apporte la recherche vectorielle indexée à PostgreSQL ; dans MySQL Community, le type VECTOR existe, mais pas la fonction DISTANCE().
- Aucun des deux n’est « plus rapide » en général : mesurez sur votre propre charge.
Versions et politiques de support
Côté PostgreSQL, la politique de versions officielle indique qu’une version majeure, publiée environ une fois par an, est « supportée 5 ans » (notre traduction), avec une mineure de correctifs au moins tous les trois mois. Le 5 novembre 2026, elle liste cinq versions maintenues, de la 14 à la 18 ; en voici trois :
| Version | Dernière mineure | Sortie | Fin de support |
|---|---|---|---|
| PostgreSQL 18 | 18.6 | 25 septembre 2025 | 14 novembre 2030 |
| PostgreSQL 17 | 17.11 | 26 septembre 2024 | 8 novembre 2029 |
| PostgreSQL 14 | 14.24 | 30 septembre 2021 | 12 novembre 2026 |
Ces mineures sont sorties ensemble le 13 août 2026 (annonce de 18.6, 17.11, 16.15, 15.19 et 14.24). PostgreSQL 19, prévu en octobre 2026 par la feuille de route, en est à la release candidate 1 du 15 octobre.
Côté MySQL, le manuel de référence 9.7 décrit deux pistes : les séries LTS (8.4 et 9.7) ont « 5 ans de support premier et 3 ans de support étendu » (notre traduction), une version Innovation n’est supportée que jusqu’à la suivante.
Après 9.7, MySQL passe à une numérotation calendaire AA.M : 26.7 désigne juillet 2026, et les notes de version datent MySQL 26.10.0 du 20 octobre 2026.
Et MariaDB ? C’est un fork de MySQL lancé par ses développeurs d’origine, qui reste sous GPLv2 (MariaDB Foundation). Sa politique de maintenance prévoit une LTS par an, maintenue trois ans en binaires communautaires ; la LTS actuelle, 12.3, est sortie le 28 mai 2026. Compatible pour le SQL courant, il diverge de MySQL sur de nombreux points : testez avant de substituer l’un à l’autre.
Licences : liberté totale contre double licence
PostgreSQL est publié sous la PostgreSQL License, « une licence open source libérale, similaire aux licences BSD ou MIT » (notre traduction). Vous pouvez l’intégrer à un produit fermé en conservant la mention de copyright.
MySQL appartient à Oracle et suit un modèle de double licence. Selon la page de licences d’Oracle, le serveur et les bibliothèques clientes sont disponibles sous GPLv2 et sous licence commerciale ; toujours selon Oracle, un éditeur qui distribue MySQL avec un logiciel dont il ne publie pas le code doit signer un contrat commercial.
Les obligations dépendent de la façon dont votre logiciel est lié à MySQL et distribué : une application web qui s’y connecte depuis votre serveur ne distribue pas MySQL. Pour un produit livré chez des clients, faites valider le montage par un juriste.
Conformité au standard SQL
PostgreSQL vise le standard le plus récent : sa documentation indique qu’il prend en charge au moins 170 des 177 fonctionnalités obligatoires de SQL:2023 Core ; aucun système ne revendique une conformité complète.
MySQL vise la conformité « sans sacrifier la vitesse ni la fiabilité » (notre traduction) et assume de nombreuses extensions, selon son manuel.
Un développeur formé au SQL standard, par exemple avec notre cours SQL pour débutant, retrouve donc plus vite ses repères dans PostgreSQL.
Types de données : JSON, tableaux, UUID, enums
JSON contre JSONB. C’est ici que PostgreSQL prend le plus d’avance. Il distingue json, copie exacte du texte, et jsonb, binaire, « nettement plus rapide à traiter » et indexable : sa documentation recommande jsonb dans la plupart des cas.
MySQL a un seul type JSON, lui aussi binaire, mais d’après son manuel, une colonne JSON ne s’indexe pas directement : on passe par une colonne générée ou un index multi-valeurs.
| Type | PostgreSQL 18 | MySQL 9.7 |
|---|---|---|
| JSON | json et jsonb, index GIN sur jsonb |
JSON binaire, index via colonne générée ou multi-valeurs |
| Tableaux | Natifs (integer[], text[]) |
Pas de type tableau, on passe par JSON |
| UUID | Type uuid, fonction uuidv7() depuis la 18 |
Pas de type dédié : UUID() et UUID_TO_BIN() vers BINARY(16) |
| Enum | CREATE TYPE ... AS ENUM, réutilisable |
ENUM(...) déclaré colonne par colonne |
| Booléen | Type boolean réel |
BOOLEAN est un synonyme de TINYINT(1) |
Sources : annonce de PostgreSQL 18 pour uuidv7(), qui génère des UUID ordonnés dans le temps, et manuel MySQL pour les booléens.
Index : la boîte à outils de PostgreSQL contre InnoDB
PostgreSQL propose six types d’index intégrés (documentation), là où InnoDB s’appuie surtout sur le B-tree :
- B-tree, le type par défaut, pour l’égalité et les intervalles.
- Hash, limité aux comparaisons d’égalité.
- GIN, des index inversés pour les valeurs composées : tableaux,
jsonb, recherche plein texte. - GiST et SP-GiST, pour les données géométriques ou les intervalles.
- BRIN, qui résume des plages de blocs : compact sur de grandes tables triées, comme des journaux horodatés.
Chez MySQL, la plupart des index sont des B-trees, sauf les R-trees spatiaux, le hachage des tables MEMORY et les listes inversées du FULLTEXT (manuel). PostgreSQL ajoute les index partiels (avec une clause WHERE) et les index sur expressions (documentation) ; MySQL indexe des expressions depuis la version 8.0.13 grâce aux « functional key parts » (manuel 8.0).
Autre différence : chaque table InnoDB stocke ses lignes dans un index clusterisé, en général la clé primaire (manuel d’InnoDB), alors que PostgreSQL les range dans un tas séparé des index.
Transactions, MVCC et niveaux d’isolation
Les deux moteurs sont ACID et multiversion (MVCC), mais pas avec le même niveau d’isolation par défaut.
| Point | PostgreSQL | MySQL (InnoDB) |
|---|---|---|
| Niveau par défaut | Read Committed | Repeatable Read |
| Read Uncommitted | Se comporte comme Read Committed | Réellement disponible |
| Lectures fantômes en Repeatable Read | Impossibles | Évitées pour les lectures simples (instantané) et verrouillantes (verrous next-key), mais un UPDATE peut toucher des lignes invisibles à l’instantané |
| DDL dans une transaction | Annulable par ROLLBACK, sauf exceptions (CREATE DATABASE, CREATE INDEX CONCURRENTLY) |
Provoque un commit implicite |
Sources : documentation de PostgreSQL sur l’isolation, manuel d’InnoDB, liste des commits implicites de MySQL, verrous next-key, lectures cohérentes d’InnoDB et page CREATE DATABASE, lus le 5 novembre 2026.
En Repeatable Read, les SELECT simples d’InnoDB lisent l’instantané de la première lecture, mais les instructions verrouillantes voient l’état le plus récent : son manuel déconseille de les mélanger.
En Read Committed, chaque requête PostgreSQL voit les données validées à son démarrage : deux lectures successives d’une même transaction peuvent différer. Fixez le niveau explicitement quand la logique métier en dépend.
Le MVCC n’est pas implémenté de la même façon. InnoDB modifie la ligne en place dans l’index clusterisé et garde les anciennes versions dans les journaux d’annulation (undo logs), qu’un processus de purge supprime ensuite (manuel d’InnoDB). PostgreSQL écrit une nouvelle version de la ligne dans la table ; l’ancienne reste jusqu’au passage de VACUUM, en pratique du démon autovacuum (documentation).
En exploitation : sur PostgreSQL, surveillez l’autovacuum des tables très modifiées ; sur InnoDB, évitez les transactions longues, qui bloquent la purge.
Réplication et haute disponibilité
PostgreSQL propose la réplication physique en streaming du journal d’écriture (WAL), asynchrone par défaut et synchrone si l’on renseigne synchronous_standby_names (documentation), ainsi que la réplication logique, table par table. Le multimaître synchrone n’est pas natif (documentation), et la bascule automatique s’appuie couramment sur un outil comme Patroni.
MySQL réplique son journal binaire, en asynchrone par défaut, avec un mode semi-synchrone et des identifiants de transaction globaux (GTID), selon son manuel. Group Replication et InnoDB Cluster ajoutent la haute disponibilité intégrée.
Extensions et IA : pgvector face au type VECTOR
PostgreSQL s’enrichit par extensions. Deux exemples dominent :
- PostGIS, pour stocker, indexer et interroger des données géospatiales (postgis.net).
- pgvector, pour la recherche de similarité vectorielle. Sa page GitHub indique, le 5 novembre 2026, la version 0.8.7, des index HNSW et IVFFlat, notamment les distances L2, produit scalaire et cosinus, et jusqu’à 2 000 dimensions indexables (4 000 en
halfvec), pour Postgres 13 et suivants.
Une recherche sémantique reste du SQL :
CREATE EXTENSION vector;
CREATE TABLE documents (id bigserial PRIMARY KEY, contenu text, embedding vector(3));
CREATE INDEX ON documents USING hnsw (embedding vector_cosine_ops);
SELECT id, contenu FROM documents ORDER BY embedding <=> '[0.1,0.2,0.3]' LIMIT 5;
C’est la brique de base d’un système RAG, avec des embeddings produits par exemple par un LLM local avec Ollama.
Et MySQL ? MySQL 9.7 a un type VECTOR de 16 383 valeurs au plus, qui ne peut servir d’aucune clé (manuel). Surtout, la page des fonctions vectorielles indique que DISTANCE() est « disponible uniquement pour les utilisateurs de MySQL HeatWave sur OCI et de MySQL AI ; elle n’est pas incluse dans les distributions MySQL Commercial ou Community » (notre traduction).
MySQL Community stocke donc des vecteurs sans calculer de distance en SQL natif. MariaDB propose un type VECTOR depuis la version 11.7.1, avec index vectoriel et fonctions de distance (documentation MariaDB).
PostgreSQL vs MySQL : les différences de syntaxe
Pour le SQL courant (SELECT, JOIN, GROUP BY), rien ne change. Les écarts se concentrent sur quelques points, d’après les documentations officielles : INSERT, fonctions de chaînes et identifiants de PostgreSQL, CREATE TABLE et fonctions de chaînes de MySQL, nouveautés de MariaDB 10.5.
| Besoin | PostgreSQL | MySQL |
|---|---|---|
| Clé auto-incrémentée | id integer GENERATED ALWAYS AS IDENTITY PRIMARY KEY (ou serial) |
id INT AUTO_INCREMENT PRIMARY KEY (la colonne doit être indexée) |
| Pagination | LIMIT 10 OFFSET 20 |
LIMIT 10 OFFSET 20 ou LIMIT 20, 10 |
| Insérer ou mettre à jour | ON CONFLICT (sku) DO UPDATE SET qte = EXCLUDED.qte |
AS nouv ON DUPLICATE KEY UPDATE qte = nouv.qte |
| Concaténation | 'a' \|\| 'b', ou concat() qui ignore les NULL |
CONCAT('a', 'b'), qui renvoie NULL si un argument est NULL ; \|\| ne concatène qu’en mode PIPES_AS_CONCAT (sinon c’est un OU logique, sans erreur) |
| Délimiter un identifiant | "ma colonne" ; sans guillemets, les noms passent en minuscules |
`ma colonne` (guillemets doubles en mode ANSI_QUOTES) |
| Booléen | Type boolean : écrivez WHERE actif, pas WHERE actif = 1 |
TRUE vaut 1, FALSE vaut 0 (TINYINT(1)) |
| Valeur de retour d’un INSERT | RETURNING id |
LAST_INSERT_ID() ; MariaDB accepte INSERT ... RETURNING depuis 10.5 |
L’upsert est l’écart le plus coûteux en migration. En PostgreSQL :
INSERT INTO stock (sku, quantite) VALUES ('A12', 5)
ON CONFLICT (sku) DO UPDATE SET quantite = stock.quantite + EXCLUDED.quantite;
En MySQL, avec l’alias de ligne recommandé par le manuel, VALUES() étant déprécié :
INSERT INTO stock (sku, quantite) VALUES ('A12', 5) AS nouv
ON DUPLICATE KEY UPDATE quantite = stock.quantite + nouv.quantite;
Pièges : ON CONFLICT (sku) exige un index ou une contrainte unique sur sku, alors que ON DUPLICATE KEY se déclenche sur n’importe quelle clé primaire ou unique de la table ; le manuel de MySQL conseille d’ailleurs d’éviter cette clause sur les tables à plusieurs index uniques. MySQL compte aussi 1 ligne affectée pour une insertion, 2 pour une mise à jour et 0 si rien ne change, ce qu’un ORM ou une API REST en Node.js doit savoir.
Autre écart en migration : avec GENERATED ALWAYS, PostgreSQL refuse un id explicite sans OVERRIDING SYSTEM VALUE. Pour importer des identifiants existants depuis MySQL, déclarez la colonne GENERATED BY DEFAULT, puis recalez la séquence après l’import, sinon le prochain INSERT sans id échouera sur une clé en double : SELECT setval(pg_get_serial_sequence('stock', 'id'), (SELECT max(id) FROM stock)); (fonctions de séquence). Ces exemples reprennent la syntaxe des manuels ; nous ne les avons pas exécutés.
Performances : ce qu’on peut dire honnêtement
Aucune source sérieuse ne permet de dire que l’un est plus rapide en général : tout dépend du schéma, des index et des requêtes.
L’annonce de PostgreSQL 18 parle de gains « jusqu’à 3 fois » grâce aux entrées-sorties asynchrones, mais « dans certains scénarios » : c’est une mesure du projet lui-même. Bytebase, éditeur d’outils pour bases de données, estime de son côté que les performances sont comparables, à 30 % près, selon son expérience : une opinion, pas une mesure (Bytebase, consulté le 5 novembre 2026).
Nous n’avons lancé aucun micro-benchmark. La bonne méthode : lancez les deux moteurs en conteneurs avec leurs images officielles (notre tutoriel Docker pour débutants suffit), chargez un échantillon de vos données et rejouez vos dix requêtes les plus fréquentes.
Réglez au moins le cache mémoire (shared_buffers côté PostgreSQL, innodb_buffer_pool_size côté MySQL) avant de comparer.
Popularité : deux mesures, deux méthodes
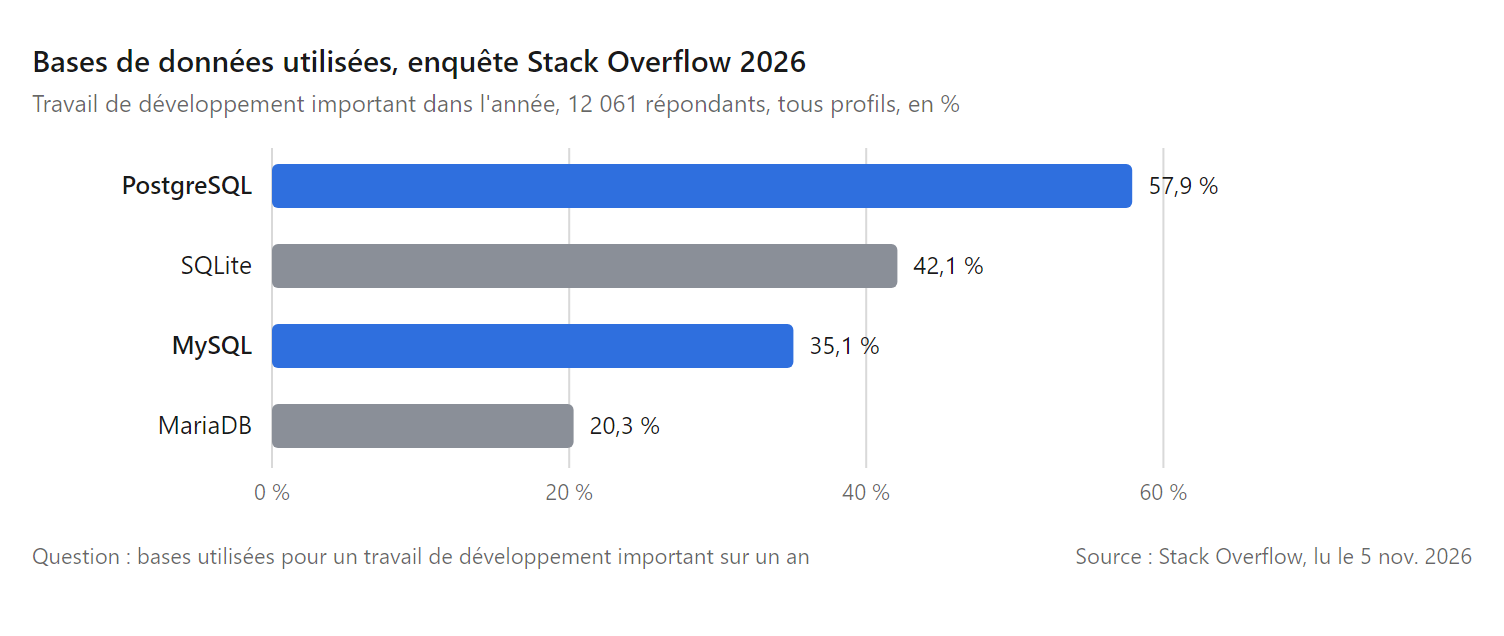
Ce que déclarent les développeurs. L’enquête Stack Overflow 2026, consultée le 5 novembre 2026, demande dans quelles bases on a fait « un travail de développement important au cours de l’année écoulée » (notre traduction). Sur les 12 061 répondants à cette question, tous profils confondus, PostgreSQL arrive en tête avec 57,9 %, devant SQLite (42,1 %), MySQL (35,1 %) et MariaDB (20,3 %). Enquête déclarative, non représentative.
Ce que mesure DB-Engines. Le classement DB-Engines de novembre 2026 place MySQL 2e avec 823,23 points et PostgreSQL 4e avec 689,69 points. Sur un an, MySQL perd 42,59 points et PostgreSQL en gagne 38,32 (scores 2025 recalculés à partir de ces écarts). La méthode combine mentions web, Google Trends, Stack Overflow, offres d’emploi, LinkedIn et X ; elle ne mesure pas les installations.
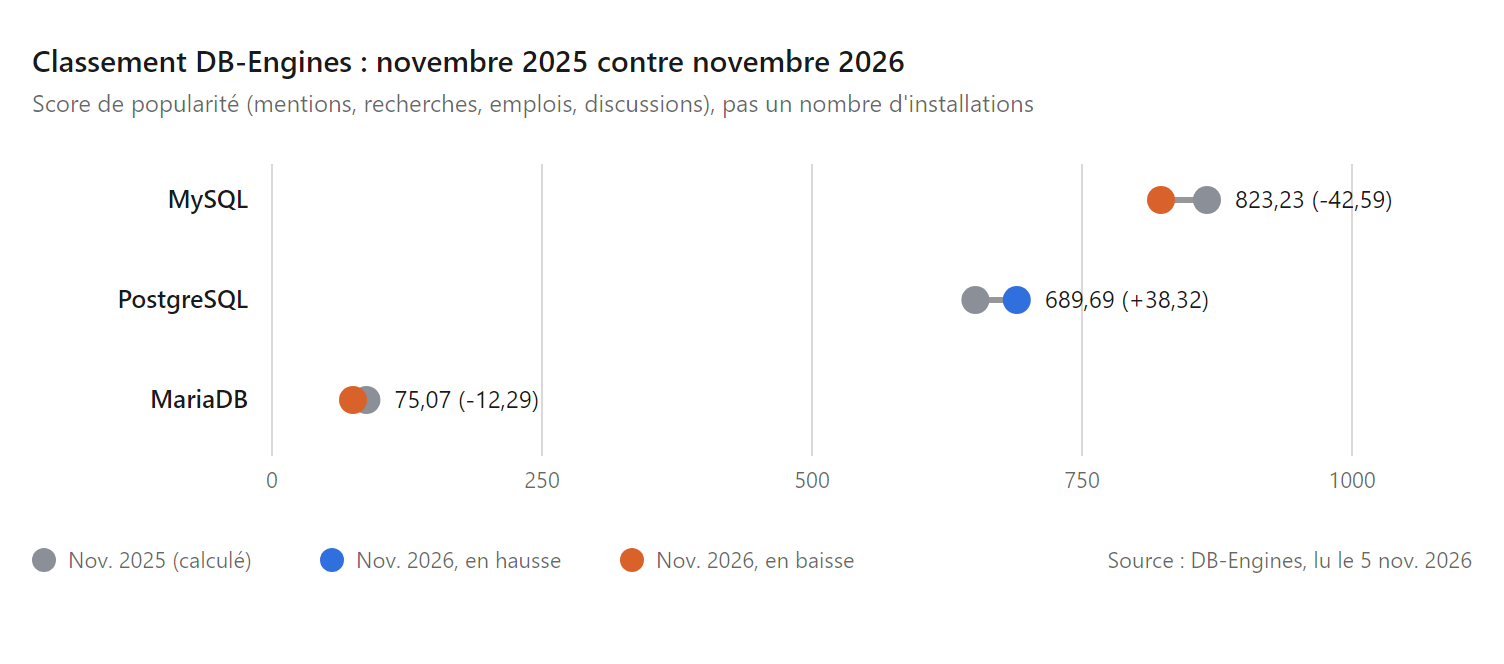
En résumé : MySQL garde un score composite DB-Engines plus élevé, mais l’écart se réduit, et PostgreSQL domine chez les répondants de Stack Overflow.
Hébergement et offres gérées
- AWS : Amazon RDS propose PostgreSQL, MySQL et MariaDB, et Aurora des éditions compatibles PostgreSQL et MySQL.
- Google Cloud : Cloud SQL prend en charge MySQL, PostgreSQL et SQL Server.
- Azure : l’offre Azure Database for MySQL flexible server s’appuie sur MySQL Community 5.7, 8.0 et 8.4 (page lue le 5 novembre 2026) : pas encore 9.7.
- WordPress : ses prérequis officiels demandent MySQL 8.0 ou plus, ou MariaDB 10.11 ou plus. PostgreSQL n’y figure pas.
Une offre gérée peut donc avoir une série LTS de retard. Pour comparer ces clouds, voyez notre comparatif AWS vs Azure vs Google Cloud et notre guide de l’hébergement cloud pour développeurs.
Grille de choix selon votre projet
Cette grille, déduite des différences documentées plus haut, ne remplace pas un test sur vos données.
| Votre projet | Notre choix | Pourquoi |
|---|---|---|
| J’apprends le SQL, premier projet | L’un ou l’autre, PostgreSQL de préférence | Même SQL de base ; PostgreSQL suit de plus près le standard |
| Nouvelle application web ou API | PostgreSQL | Types riches, jsonb, DDL transactionnel, licence permissive |
| WordPress ou autre CMS PHP conçu pour MySQL | MySQL ou MariaDB | WordPress exige MySQL ou MariaDB dans ses prérequis |
| Site PHP sur hébergement mutualisé | La base fournie par l’offre | Vérifiez la base incluse avant de choisir |
| Recherche sémantique, RAG, embeddings | PostgreSQL avec pgvector | Distance et index vectoriels dans l’édition libre |
| Données géographiques | PostgreSQL avec PostGIS | Types et index spatiaux par extension |
| Équipe experte en MySQL, charge simple | MySQL | La compétence de l’équipe prime |
| Logiciel distribué chez vos clients avec base embarquée | PostgreSQL | Pas de licence commerciale à négocier |
| Besoin d’un fork libre compatible MySQL | MariaDB | GPLv2, recherche vectorielle native |
En cas de doute, le comparatif PostgreSQL vs MySQL penche vers PostgreSQL pour un projet neuf, et vers MySQL quand l’existant l’impose.
Ce que nous n’avons pas pu vérifier
- Les performances et les exemples SQL. Docker n’était pas disponible : aucun benchmark n’a été lancé et aucun exemple n’a été exécuté.
- Les dates de fin de support de MySQL 8.4 et 9.7. Le manuel donne la règle (5 ans plus 3 ans), pas les dates.
- L’annonce d’octobre 2026 de MySQL sur le blog d’Oracle, inaccessible depuis nos outils.
- La sortie finale de PostgreSQL 19, non publiée le 5 novembre 2026.
Questions fréquentes
PostgreSQL ou MySQL : lequel choisir pour débuter ?
Les deux conviennent. PostgreSQL suit de plus près le standard SQL ; MySQL ou MariaDB s’imposent si vous visez WordPress. Notre cours SQL pour débutant fonctionne avec les deux.
PostgreSQL est-il plus rapide que MySQL ?
Pas en général. Même l’annonce de PostgreSQL 18 parle de gains « dans certains scénarios ».
MySQL Community permet-il la recherche vectorielle ?
En partie : le type VECTOR existe, mais selon le manuel MySQL 9.7, DISTANCE() est réservée à HeatWave sur OCI et à MySQL AI. Les options libres documentées sont pgvector et MariaDB 11.7 ou plus.
Peut-on migrer de MySQL vers PostgreSQL facilement ?
Le SQL courant passe. Reprenez l’auto-incrément, l’upsert, les guillemets, les booléens et l’isolation par défaut, puis testez tout.
À propos de l’auteur
Abdelilah Ourti est ingénieur IA et architecte logiciel. Il conçoit et déploie des applications web et des systèmes d’IA, et publie sur NeurauTech des guides et des comparatifs destinés aux développeurs francophones. Ses autres articles sont réunis sur sa page auteur.
Méthode. Synthèse fondée exclusivement sur des sources publiques lues le 5 novembre 2026 : documentation officielle de PostgreSQL, de MySQL et de MariaDB, pages des fournisseurs cloud, enquête Stack Overflow 2026 et classement DB-Engines. Les chiffres d’éditeurs sont signalés comme tels. Les citations issues de sources en anglais sont traduites par nos soins. Aucun test ni benchmark n’a été mené, aucun lien n’est affilié et aucune relation commerciale ne lie l’auteur aux éditeurs mentionnés.
Une erreur ou une version périmée ? Écrivez à [email protected] : l’article sera corrigé et la date de mise à jour modifiée.
Dernière mise à jour : 5 novembre 2026.
Image d’en-tête : Taylor Vick (Unsplash License).