Meilleur LLM local : 8 modèles mesurés sur un portable de 8 Go
L’essentiel en une minute
Le meilleur LLM local dépend d’abord de votre machine, et la plupart des comparatifs n’en mesurent aucune. Nous avons donc fait tourner 8 modèles open-weight récents avec Ollama sur un portable ordinaire, sans carte graphique dédiée et avec 8 Go de mémoire, les 6 et 7 novembre 2026. Chaque modèle a reçu les mêmes consignes : 6 exercices de code vérifiés par des tests unitaires, 8 questions en français à réponse connue et un résumé noté sur une grille fixée à l’avance. Nous les avons ensuite confrontées aux chiffres publiés.
Sur cette machine, Gemma 4 E2B est le seul à réussir tous les tests de code et toutes les questions, au prix de 47 secondes de chargement. Ministral 3 3B le suit (5 tests de code sur 6, 8 questions sur 8) et se charge en 17 secondes. En vitesse, l’écart reste faible : de 5 à 7,5 tokens par seconde en génération.
Points clés
- Sur un portable à 8 Go sans GPU, les modèles de 1,9 à 4,6 milliards de paramètres (selon Ollama) génèrent entre 5,0 et 7,5 tokens par seconde (médiane de 3 exécutions, sur secteur).
- Gemma 4 E2B réussit 6 tests de code sur 6 et 8 questions sur 8 ; Ministral 3 3B et Qwen3.5 4B réussissent 5 tests sur 6. Llama 3.2 3B et Qwen3.5 2B n’en réussissent qu’un.
- La lecture du prompt est le vrai goulot : 14 à 43 tokens par seconde, soit 15 à 45 secondes d’attente pour un texte de 600 tokens.
- Des mesures publiées sur des portables à 16 et 32 Go sont plus rapides : processeur, système et mémoire diffèrent, le manque de mémoire est une explication probable. Notre 7B a planté une fois et n’a pas dépassé 2 tokens par seconde (mesure indicative).
- Ce sont les résultats d’une machine et d’un petit jeu de tests, pas un classement général.
L’installation d’Ollama, la quantification et l’API locale sont expliquées dans notre guide LLM local avec Ollama. Cet article ne les répète pas : il donne des mesures.
La machine et les 8 modèles
Nous avons choisi un portable courant, sans carte graphique dédiée. Pour choisir une machine plus adaptée, voyez notre comparatif du meilleur laptop pour développeur.
| Élément | Valeur relevée le 6 novembre 2026 |
|---|---|
| Ordinateur | Huawei NBLB-WAX9N (portable) |
| Processeur | Intel Core i5-10210U, 4 cœurs, 8 threads, 1,6 GHz de base |
| Mémoire | 8 Go de DDR4-2667 (2 barrettes de 4 Go) |
| Graphique | Intel UHD Graphics intégré, écarté par Ollama : calcul sur le processeur seul |
| Système | Windows 11 Famille, build 26300 |
| Logiciel | Ollama 0.40.15, archive officielle pour Windows |
| Applications ouvertes | VS Code, Chrome et un terminal |
Les modèles viennent de la bibliothèque Ollama, consultée le 6 novembre 2026 : des familles récentes qui tiennent dans 8 Go, avec l’étiquette par défaut de ollama pull.
| Modèle | Étiquette Ollama | Paramètres | Quantification | Téléchargement |
|---|---|---|---|---|
| Qwen3.5 2B | qwen3.5:2b |
1,9 Md | Q8_0 | 2,7 Go |
| Qwen2.5-Coder 3B | qwen2.5-coder:3b |
3,1 Md | Q4_K_M | 1,9 Go |
| Llama 3.2 3B | llama3.2:3b |
3,2 Md | Q4_K_M | 2,0 Go |
| Ministral 3 3B | ministral-3:3b |
3,8 Md | Q4_K_M | 3,0 Go |
| Phi-4-mini | phi4-mini |
3,8 Md | Q4_K_M | 2,5 Go |
| Qwen3.5 4B | qwen3.5:4b |
4,2 Md | Q4_K_M | 3,3 Go |
| Gemma 4 E2B | gemma4:e2b |
4,6 Md | Q4_K_M | 4,6 Go |
| Qwen2.5-Coder 7B | qwen2.5-coder:7b |
7,6 Md | Q4_K_M | 4,7 Go |
Paramètres et quantification sont ceux que renvoie Ollama. Gemma 4 E2B pèse plus que son nom ne le laisse penser : sa fiche officielle indique 2,3 milliards de paramètres effectifs mais 5,1 milliards avec les tables d’embeddings.
La méthode
Les réglages étaient identiques pour tous : température 0, graine fixée à 42, contexte de 4 096 tokens, mode « réflexion » désactivé (think: false), un seul modèle chargé à la fois. Les durées viennent de l’API locale d’Ollama (documentation).
Vitesse. La même question (« Explique en cinq phrases à un développeur débutant ce qu’est un index dans une base de données relationnelle ») a été posée trois fois, modèle déchargé avant chaque essai : le chargement est mesuré à froid. Pour la lecture d’un long prompt, le texte à résumer (environ 600 tokens) a été envoyé trois fois, modèle déchargé pour éviter le cache. Nous publions la médiane.
Code. Six fonctions Python, chacune vérifiée par des tests unitaires exécutés sur la machine : fizzbuzz, validation de parenthèses, chiffres romains, fusion d’intervalles, conversion d’une durée comme « 1h30m15s » en secondes, mots les plus fréquents d’un texte français. C’est le niveau de nos exercices Python corrigés, pas celui d’un projet réel.
Questions en français. Huit questions à réponse unique : capitale de l’Australie, heure d’arrivée d’un train, règle de trois, plus grand nombre premier sous 50, auteur des « Misérables », énigme « Marie a 3 frères, chacun a 2 sœurs », prise de la Bastille, baisse puis hausse de 25 %. Le modèle devait finir par une ligne « Réponse : … », lue automatiquement.
Résumé. Un compte rendu de réunion fictif, à résumer en 80 mots. La grille, fixée avant les mesures, donne 5 points : décision, date, budget, risque principal, et 100 mots au plus en français. Les réponses étaient plafonnées à 128 tokens pour la vitesse, 450 pour le code, 160 pour les questions et 200 pour le résumé.
Vitesse : ce que donne un CPU seul
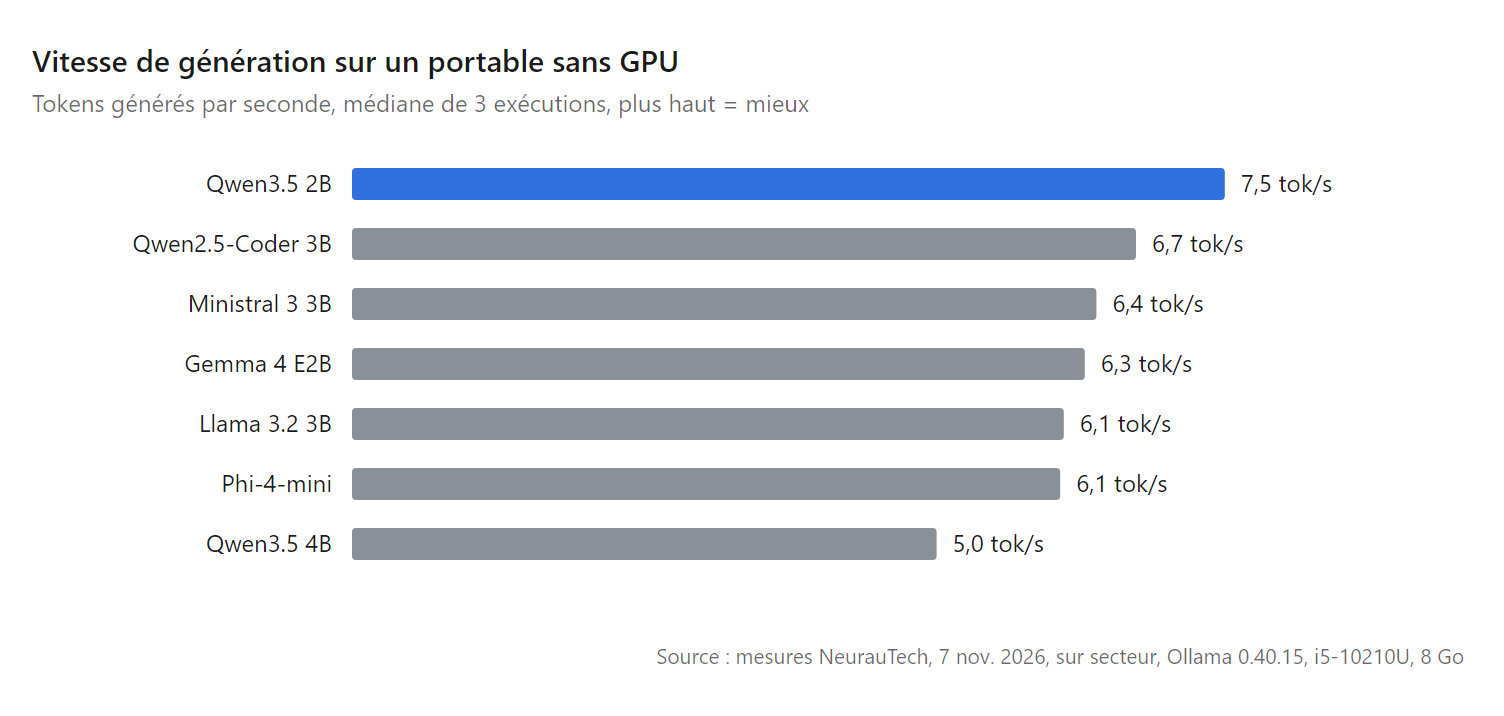
Sur ce processeur, aucun modèle ne dépasse 7,5 tokens par seconde en génération. Mesures du 7 novembre 2026, dans une même session, sur secteur du début à la fin de chaque modèle.
| Modèle | Chargement à froid | Lecture du prompt long | Génération |
|---|---|---|---|
| Qwen3.5 2B | 10,9 s | 19,9 tok/s | 7,5 tok/s |
| Qwen2.5-Coder 3B | 9,0 s | 24,8 tok/s | 6,7 tok/s |
| Ministral 3 3B | 16,7 s | 20,0 tok/s | 6,4 tok/s |
| Gemma 4 E2B | 47,5 s | 43,0 tok/s | 6,3 tok/s |
| Llama 3.2 3B | 8,7 s | 23,1 tok/s | 6,1 tok/s |
| Phi-4-mini | 8,8 s | 18,2 tok/s | 6,1 tok/s |
| Qwen3.5 4B | 11,1 s | 13,7 tok/s | 5,0 tok/s |
Médiane de 3 exécutions. Mesures NeurauTech du 7 novembre 2026, Ollama 0.40.15, Core i5-10210U, 8 Go, sur secteur. Avec 3 exécutions seulement, un écart de moins de 1 token par seconde entre deux modèles n’est pas significatif. Qwen2.5-Coder 7B est traité à part, plus bas.
La lecture du prompt compte plus que la génération : à 14 à 43 tokens par seconde, un texte de 600 tokens impose 15 à 45 secondes d’attente avant le premier mot. Un assistant de code qui envoie un fichier entier, ou un système RAG qui ajoute des passages au prompt, devient vite pénible sur ce type de machine. Gemma 4 E2B lit le prompt 1,7 fois plus vite que le suivant (médiane de 43,0 contre 24,8 tokens par seconde, avec des essais de 38 à 83 tokens par seconde), ce qui compense en partie son chargement.
Le chargement prend 9 à 17 secondes, mais 47,5 secondes pour Gemma 4 E2B. Ollama garde le modèle chargé 5 minutes après la dernière requête (réglage OLLAMA_KEEP_ALIVE par défaut, relevé dans le journal du serveur) : ce délai ne se paie qu’au premier appel ou après une pause. Une première série faite en partie sur batterie a été écartée, car les vitesses n’étaient pas comparables.
Qualité : code exécuté, questions et résumé
Gemma 4 E2B est le seul modèle sans faute sur nos tests. Ces scores ne dépendent pas de l’alimentation : avec une température de 0 et une graine fixe, le résumé, répété sur batterie puis sur secteur, est resté identique mot pour mot ; code et questions n’ont été passés qu’une fois.
| Modèle | Code (tests réussis) | Questions en français | Résumé (grille sur 5) |
|---|---|---|---|
| Gemma 4 E2B | 6 / 6 | 8 / 8 | 5 / 5 |
| Ministral 3 3B | 5 / 6 | 8 / 8 | 5 / 5 |
| Qwen3.5 4B | 5 / 6 | 7 / 8 | 5 / 5 |
| Qwen2.5-Coder 3B | 4 / 6 | 8 / 8 | 5 / 5 |
| Phi-4-mini | 2 / 6 | 7 / 8 | 5 / 5 |
| Qwen3.5 2B | 1 / 6 | 6 / 8 | 5 / 5 |
| Llama 3.2 3B | 1 / 6 | 5 / 8 | 5 / 5 |
| Qwen2.5-Coder 7B | Non mesuré | Non mesuré | Non mesuré |
Mesures NeurauTech, 6 et 7 novembre 2026. Température 0, graine 42, contexte 4 096 tokens. Les scores de six modèles viennent de la première série (6 et 7 novembre) : Gemma 4 E2B, Qwen2.5-Coder 3B, Qwen3.5 2B et Qwen3.5 4B y ont tourné sur batterie, Llama 3.2 3B et Phi-4-mini sur secteur. Seule la vitesse de cette série a été écartée. Ministral 3 3B a été noté le 7 novembre sur secteur. Le test de qualité de Qwen2.5-Coder 7B a été arrêté avant la fin.
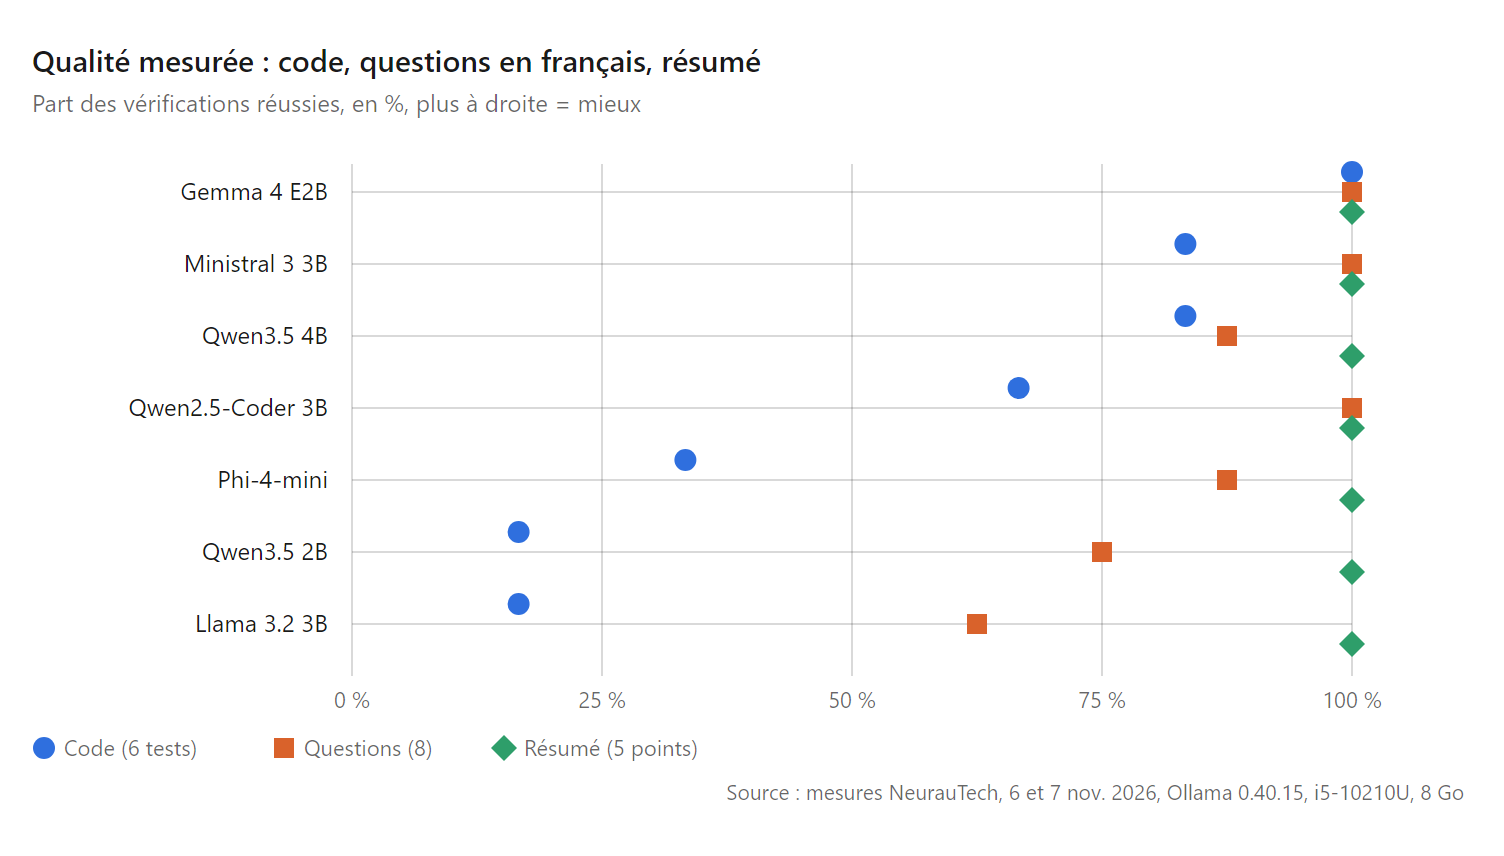
Le code départage les modèles. Seul Gemma 4 E2B a réussi la conversion de durée (« 1h30m15s » en secondes) ; Qwen2.5-Coder 3B, Qwen3.5 4B et Ministral 3 3B ont écrit des fonctions qui plantent sur cette entrée. Les petits généralistes font des erreurs plus basiques : Qwen3.5 2B accepte « (] » comme une expression bien parenthésée, Phi-4-mini rend deux fois du code qui ne compile pas.
Les questions piègent surtout sur le raisonnement. L’énigme des sœurs (réponse : 2) a été manquée par Qwen3.5 2B, qui répond 4, et par Llama 3.2 3B, qui répond 7. Phi-4-mini annonce 60 euros au lieu de 75 pour la baisse puis la hausse de 25 %. Trois échecs tiennent à nos règles : Llama 3.2 3B a écrit deux fois « Réponse : … » au lieu de recopier sa bonne réponse (capitale et Bastille), et Qwen3.5 4B a dépassé le plafond de 160 tokens avant de conclure.
Le résumé ne départage personne : 5 sur 5 pour tous, notre grille était trop facile.
Mémoire : la vraie limite d’un portable de 8 Go
Sur 8 Go partagés avec Windows, VS Code et Chrome, un modèle 7B ne passe pas confortablement. Au premier essai sur secteur, Qwen2.5-Coder 7B s’est chargé en 113 secondes et a généré à 1,2 token par seconde, puis le processus d’inférence d’Ollama s’est arrêté au rechargement suivant (« connexion fermée de force par l’hôte distant »). Au second essai, il a tenu trois chargements (54 à 87 secondes) pour 1,0 à 2,0 tokens par seconde. Le premier essai n’a donné qu’une exécution et l’ordinateur a été débranché pendant le second : tous ces chiffres sont indicatifs.
Pour les modèles de 1,9 à 4,6 milliards de paramètres (selon Ollama), le pic de mémoire occupé par Ollama est resté entre 2,1 et 3,2 Go. Pendant chaque test, la mémoire disponible du système est tombée à presque zéro selon notre relevé, Windows compressant et déplaçant le reste vers le disque.
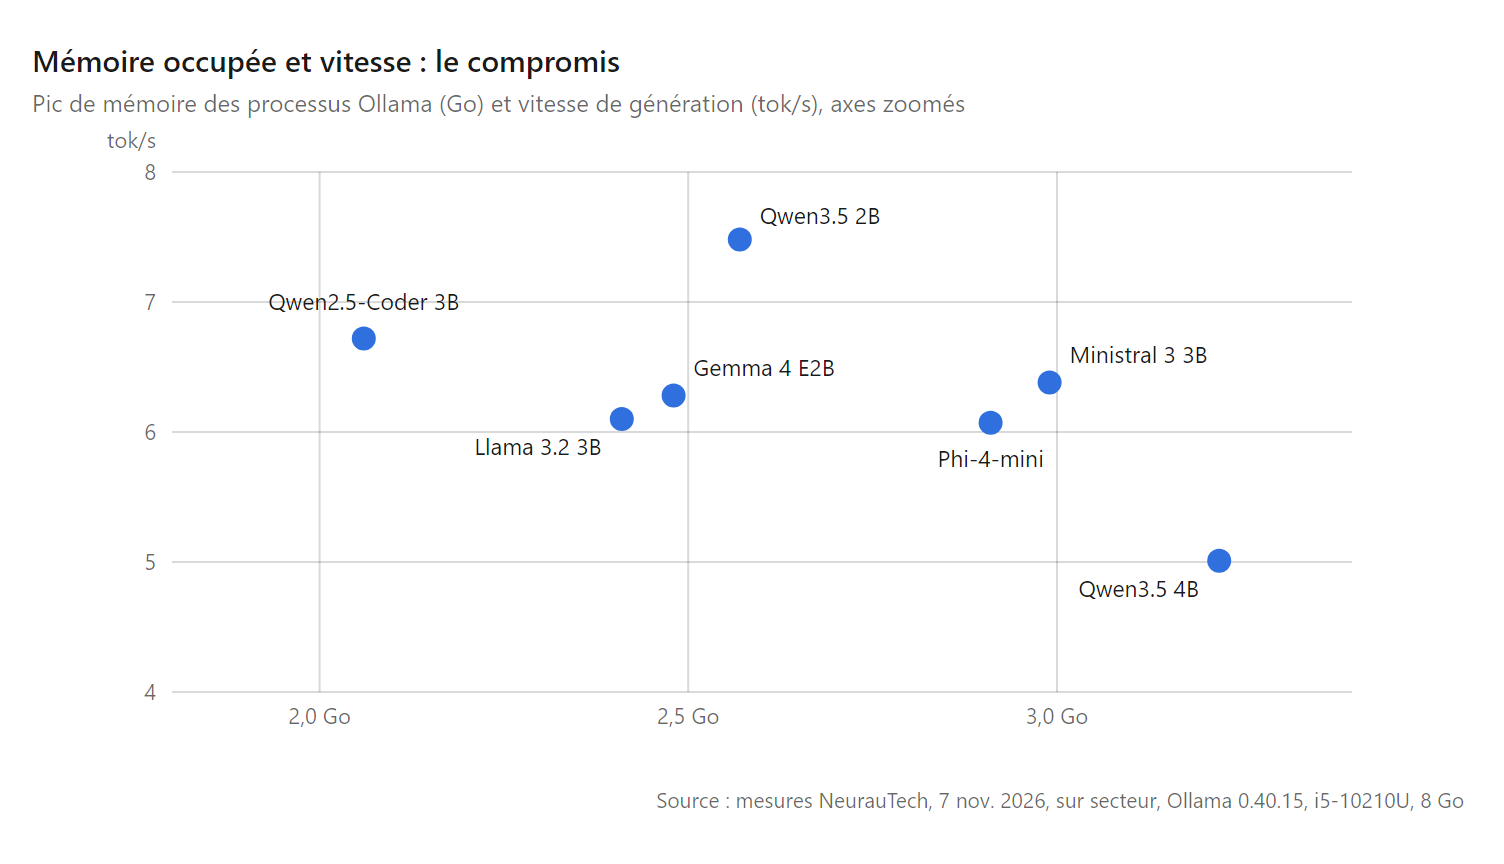
Cette mesure (mémoire de travail des processus Ollama, relevée toutes les 0,25 seconde) sous-estime la place réelle quand Windows manque de mémoire : Gemma 4 E2B, avec un fichier de 4,6 Go, n’affiche que 2,5 Go de pic.
Nos mesures face aux chiffres publiés
Les chiffres publiés montrent des vitesses plus élevées sur d’autres machines, mieux dotées en mémoire, et les scores des éditeurs nuancent notre classement en code. Lus le 7 novembre 2026, ils sont présentés à part, car les conditions diffèrent.
Vitesse sur processeur seul. Nous n’avons trouvé que deux mesures publiées avec un matériel précis. Système, logiciel, mémoire et méthode diffèrent des nôtres : la comparaison n’est qu’indicative.
| Source | Machine | Modèle | Génération | Lecture du prompt |
|---|---|---|---|---|
| NeurauTech, 7 nov. 2026 | i5-10210U, 8 Go DDR4, Windows, Ollama 0.40.15 | Llama 3.2 3B (Q4_K_M) | 6,1 tok/s | 23,1 tok/s |
| jtmoulia, 16 nov. 2024 | i7-1185G7, 32 Go DDR4, Linux, Ollama 0.4.2 | llama3.2:3b |
14 tok/s | Non publié |
| jtmoulia, 16 nov. 2024 | Même portable | qwen2.5-coder:7b |
8 tok/s | Non publié |
| Marcus Groeber, 2 févr. 2026 | i7-8550U, 16 Go, llama.cpp, 8 threads | Llama 7B (Q4_0) | 6,37 tok/s | 16,29 tok/s |
Le portable de jtmoulia, mesuré avec une seule consigne et une méthode non détaillée, avait 32 Go : il génère plus de deux fois plus vite que nous sur Llama 3.2 3B. Le portable de Marcus Groeber, un processeur de 2018 avec 16 Go, obtient 6,37 tokens par seconde avec un modèle 7B dans l’outil de mesure llama-bench de llama.cpp. Nous ne pouvons pas isoler la cause : processeur, système, logiciel et mémoire diffèrent. La mémoire est une piste probable, car la mémoire disponible tombait à presque zéro pendant nos tests.
Scores publiés par les éditeurs. Ces chiffres viennent des fiches officielles et ne sont pas vérifiés de façon indépendante. Ils sont obtenus dans des conditions que les fiches ne détaillent pas toujours (quantification, mode « réflexion »), sur des tests qui changent d’un éditeur à l’autre : ne comparez que des scores du même test.
| Modèle | Code (score publié par l’éditeur) | Connaissances | Source |
|---|---|---|---|
| Qwen3.5 4B | LiveCodeBench v6 : 55,8 | MMLU-Pro : 79,1 ; MMMLU : 76,1 | Fiche Qwen, consultée le 7 nov. 2026, mode non précisé (réflexion par défaut) |
| Gemma 4 E2B | LiveCodeBench v6 : 44,0 % | MMLU Pro : 60,0 % ; MMMLU : 67,4 % | Fiche Google, consultée le 7 nov. 2026 |
| Qwen3.5 2B | Non publié | MMLU-Pro : 55,3 sans réflexion, 66,5 avec | Fiche Qwen, consultée le 7 nov. 2026 |
| Qwen2.5-Coder 3B | HumanEval : 84,1 ; MBPP : 73,6 | Non publié | Rapport technique, v3 du 12 nov. 2024, consulté le 7 nov. 2026 |
| Qwen2.5-Coder 7B | HumanEval : 88,4 ; MBPP : 83,5 | Non publié | Rapport technique, v3 du 12 nov. 2024, consulté le 7 nov. 2026 |
| Phi-4-mini | Non publié | MMLU : 67,3 ; MMLU multilingue : 49,3 | Fiche Microsoft, février 2025, consultée le 7 nov. 2026 |
| Llama 3.2 3B | Non publié | MMLU : 63,4 ; MMLU en français : 54,6 | Fiche Meta, septembre 2024, consultée le 7 nov. 2026 |
| Ministral 3 3B | Non publié pour la version Instruct | Arena Hard : 0,305 ; WildBench : 56,8 | Fiche Mistral AI, consultée le 7 nov. 2026 |
Trois enseignements. D’abord, selon leurs éditeurs, Qwen3.5 4B devance Gemma 4 E2B sur LiveCodeBench v6 (55,8 contre 44,0), l’inverse de notre petit test. La fiche de Qwen3.5 4B ne précise pas le mode utilisé et indique que le modèle réfléchit par défaut ; nous avions coupé ce mode. Ensuite, le mode réflexion pèse lourd : Qwen publie pour Qwen3.5 2B un MMLU-Pro de 55,3 sans réflexion et 66,5 avec. Enfin, les éditeurs ne mesurent pas tous de la même façon : Meta donne 63,4 au MMLU pour Llama 3.2 3B, la fiche de Phi-4-mini lui attribue 65,0.
Côté classements indépendants, la page des petits modèles open source d’Artificial Analysis, consultée le 7 novembre 2026, couvre les modèles de 4 à 40 milliards de paramètres et affiche les 12 premiers de son indice de progression, de Nanbeige4.3-33B (306 points) à Qwen3.6 35B A3B sans réflexion (246 points). Aucun des modèles que nous avons mesurés ne figure parmi ces 12, et la page de Gemma 4 E2B n’affiche pas de score.
Quel est le meilleur LLM local selon l’usage
Sur cette machine, le meilleur LLM local polyvalent est Gemma 4 E2B, si vous acceptez 47 secondes de chargement. Les chiffres publiés ne changent pas ce choix, mais ils ajoutent une option pour le code.
| Usage | Notre choix sur ce portable | Pourquoi | Alternative |
|---|---|---|---|
| Coder | Gemma 4 E2B | 6 tests sur 6, lecture de prompt la plus rapide | Qwen3.5 4B : 55,8 sur LiveCodeBench v6 selon Qwen (mode non précisé, réflexion par défaut), plus lent si la réflexion est active |
| Discuter en français | Gemma 4 E2B | 8 questions sur 8, dont l’énigme des sœurs | Ministral 3 3B (8 sur 8, chargement en 17 s) |
| Portable avec peu de RAM | Qwen2.5-Coder 3B | Plus petit fichier (1,9 Go) et pic mesuré le plus bas (2,1 Go), 4 tests de code sur 6, chargement en 9 s | Qwen3.5 4B si 1 Go de plus est libre |
| À éviter sur 8 Go | Qwen2.5-Coder 7B | Un plantage d’Ollama, 1 à 2 tok/s (indicatif) | Mesures publiées : 6 à 8 tok/s pour un 7B avec 16 ou 32 Go |
Pour coder, le meilleur LLM local sur 8 Go reste un complément aux assistants en ligne : à 6 tokens par seconde, une réponse de 300 tokens prend environ 50 secondes. Le mode réflexion de Qwen3.5 4B, actif par défaut selon sa fiche, ajoute des tokens avant chaque réponse : nous ne l’avons pas mesuré, mais chacun allonge l’attente. Les études sur le gain de productivité sont résumées dans notre article sur l’IA pour coder plus vite ; pour l’éditeur de code, le guide Ollama détaille l’extension Continue, et nos raccourcis VS Code font gagner du temps.
Pour discuter en français, les erreurs relevées viennent surtout du raisonnement ; nous n’avons pas noté la qualité du français. Gemma 4 E2B, Ministral 3 3B et Qwen2.5-Coder 3B ont fait 8 sur 8.
Pour un portable avec peu de mémoire, fermez le navigateur avant de charger le modèle, gardez un contexte de 4 096 tokens et préférez un modèle de 3 milliards de paramètres. Si vous achetez une machine pour l’IA locale, visez au moins 16 Go : sur 8 Go, notre système manquait de mémoire pendant chaque test, et les mesures publiées sur 16 et 32 Go sont plus rapides, sur d’autres processeurs. Pour relier ensuite le modèle à vos outils, notre guide du serveur MCP explique le protocole.
Les limites de ce banc d’essai
Ce banc d’essai ne remplace pas un classement général :
- Une seule machine, non isolée. VS Code et Chrome restaient ouverts.
- Un petit échantillon. Six exercices de code et huit questions montrent les grands écarts, pas les petits : un exercice de plus peut inverser deux lignes du tableau.
- Des étiquettes par défaut. Qwen3.5 2B est livré en Q8_0, les autres en Q4_K_M : c’est ce qu’obtient l’utilisateur, mais la quantification n’est pas égale.
- Réflexion désactivée. Qwen3.5 et Gemma 4 savent « réfléchir » avant de répondre. Nous avons coupé ce mode pour comparer à réglages égaux, alors que certains scores publiés l’utilisent.
Ce que nous n’avons pas pu vérifier
- Des mesures publiées sur processeur pour Gemma 4, Qwen3.5 ou Ministral 3 : nous n’en avons trouvé aucune avec un matériel précis.
- Le classement de LiveCodeBench : sa page publique ne s’est pas chargée lors de notre consultation, nous n’avons donc pas pu y situer ces modèles.
- Le mode des scores de Qwen3.5 4B : sa fiche ne dit pas s’ils ont été obtenus avec ou sans réflexion.
- Le GPU intégré : Ollama l’écarte par défaut, et nous n’avons pas activé le réglage
OLLAMA_IGPU_ENABLE.
Questions fréquentes
Quel est le meilleur LLM local pour un PC avec 8 Go de RAM ?
Sur notre portable de 8 Go sans GPU, Gemma 4 E2B a réussi tous nos tests de code et toutes nos questions en français, à 6,3 tokens par seconde. Si la mémoire est très juste, Qwen2.5-Coder 3B a le plus petit fichier (1,9 Go) et le pic mesuré le plus bas (2,1 Go), et reste correct en code.
Quel LLM local choisir pour coder ?
Sur notre machine, Gemma 4 E2B (6 tests sur 6), puis Ministral 3 3B et Qwen3.5 4B (5 sur 6). Selon Qwen, Qwen3.5 4B obtient 55,8 sur LiveCodeBench v6, contre 44,0 % pour Gemma 4 E2B selon Google. La fiche de Qwen ne précise pas le mode utilisé, et le modèle réfléchit par défaut, ce qui ralentit chaque réponse sur un processeur seul.
Un LLM local est-il assez rapide sans carte graphique ?
Pour des questions courtes, oui : à 5 à 7,5 tokens par seconde, une réponse de 300 tokens arrive en 40 à 60 secondes. Avec de longs documents, la lecture du prompt (14 à 43 tokens par seconde ici) devient le facteur limitant.
Peut-on faire tourner un modèle 7B avec 8 Go de RAM ?
Sur notre machine, pas de façon fiable : Qwen2.5-Coder 7B a fait planter Ollama une fois et n’a pas dépassé 2 tokens par seconde (mesure indicative). Sur une machine mieux dotée, un portable à 32 Go, le même modèle a été mesuré à 8 tokens par seconde ; processeur et système y étaient aussi différents.
À propos de l’auteur
Abdelilah Ourti est ingénieur IA et architecte logiciel. Il conçoit et déploie des applications web et des systèmes d’IA, et publie sur NeurauTech des guides et des comparatifs destinés aux développeurs francophones. Ses autres articles sont réunis sur sa page auteur.
Méthode. Mesures prises les 6 et 7 novembre 2026 sur le portable de l’auteur décrit plus haut, avec Ollama 0.40.15 et un script Python. Chaque chiffre retenu vient d’une seule série de mesures ; rien n’a été remesuré après le 7 novembre. Nos vitesses ont été mesurées sur secteur le 7 novembre (sauf le second essai, indicatif, de Qwen2.5-Coder 7B) ; une première série en partie sur batterie a été écartée pour la vitesse. Les fichiers téléchargés (8 modèles, 24,7 Go, et Ollama) ont été supprimés ensuite. Chiffres des éditeurs et des tiers lus le 7 novembre 2026. Aucun lien affilié.
Une erreur ou une mesure à refaire ? Écrivez à [email protected] : l’article sera corrigé et la date de mise à jour modifiée.
Dernière mise à jour : 7 novembre 2026.
Image : Adhitya Sibikumar (Unsplash License). Graphiques : NeurauTech, à partir de nos mesures.